カテゴリー: 作る

  • ChatGPTにURLを使って情報を渡す

     Chat GPTに事前に情報を渡して学習させる方法

    1.Webスクレイピングという技術

     WebサイトからWebページのHTMLデータを取得し、
       見出しや写真といった特定のデータを抽出する技術
       データの取得を「クロール」、データの抽出を「スクレイプ」と呼ぶ

     Pythonのスクレイピングに適したライブラリ

    Webページ取得データ抽出特徴
    Requests○✖️Webページを取得する
    シンプルで人が直感的に分かりやすいプログラムを記述できる
    Beautiful Soup✖️○取得したWebページの情報を加工する
    Selenium○○Webページ取得と、データ抽出の両方が利用できる
    JavaScriptが使用されたサイトやログインにも使用できる
    動作が遅いのがデメリット

     RequestsでHTMLのデータを取得し、
       BeautifulSoupでページのタイトルや見出しなどの情報を摘出する

    2.パラメータ設定

    import requests
    from bs4 import BeautifulSoup
    
    # 指定したURLのWebページを取得
    url = 'https://example.com'
    res = requests.get(url)
    
    # BeautifulSoupを使ってWebページのテキストを取得
    soup = BeautifulSoup(res.text, 'html.parser')
    text = soup.get_text()
    
    # 取得したテキストをチャットGPTに渡す
    response = chat_gpt.generate(text)

    3.注意点

     Webスクレイピングは、Webページの利用規約に違反する場合がある
       事前に利用規約を確認し、適切に利用する必要がある

     Webスクレイピングは、自動的に大量のリクエストを送信するため、
       Webサイトのサーバーに負荷をかける可能性がある
       適切な間隔を空けてリクエストを送信する

     Webサイト内の情報やコンテンツを
       複製・再利用することが禁止されている場合が多いので注意すること

  • 並べ替え(アルゴリズム)

      Pythonで6種類の並べ替えアルゴリズムを調べる
        昇順に並べ替えることを前提とする(降順は内容を読み替えてください)

    1.バブルソート

     隣同士の値を比較、必要があれば入れ替え、を繰り返して整列させる
       計算回数は、O(n^2)

     サンプルコード

    def bubble_sort(arr):
        n = len(arr)
        for i in range(n):
            for j in range(0, n-i-1):
                if arr[j] > arr[j+1]:
                    arr[j], arr[j+1] = arr[j+1], arr[j]
    
    # 使用例
    arr = [64, 34, 25, 12, 22, 11, 90]
    bubble_sort(arr)
    print("ソート済み配列:")
    for i in range(len(arr)):
        print("%d" %arr[i]),

    2.クイックソート

     基準値を設けて、基準値より大きいブロックと小さいブロックに分けて並び替える
       計算回数は、O(n log n)

     サンプルコード

    def quick_sort(arr, low, high):
        if low < high:
            # pivotを決定する
            pivot_index = partition(arr, low, high)
    
            # pivotを中心に左側をソートする
            quick_sort(arr, low, pivot_index - 1)
            # pivotを中心に右側をソートする
            quick_sort(arr, pivot_index + 1, high)
    
    def partition(arr, low, high):
        # pivotを最後の要素に設定する
        pivot = arr[high]
        # pivotより小さい要素を左側に、大きい要素を右側に配置する
        i = low - 1
        for j in range(low, high):
            if arr[j] < pivot:
                i += 1
                arr[i], arr[j] = arr[j], arr[i]
        # pivotを適切な位置に配置する
        arr[i+1], arr[high] = arr[high], arr[i+1]
        return i+1
    
    # 使用例
    arr = [64, 34, 25, 12, 22, 11, 90]
    n = len(arr)
    quick_sort(arr, 0, n-1)
    print("ソート済み配列:")
    for i in range(n):
        print("%d" % arr[i]),

    3.マージソート

     対象のデータを分割し、分割後の小さいブロック内で整列、再度統合する
       計算回数は、O(n log n)

     サンプルコード

    def merge_sort(arr):
        if len(arr) > 1:
            # 中央の位置を求める
            mid = len(arr) // 2
    
            # 左側と右側に分割する
            left_half = arr[:mid]
            right_half = arr[mid:]
    
            # 左側と右側を再帰的にソートする
            merge_sort(left_half)
            merge_sort(right_half)
    
            # ソート済みの左側と右側をマージする
            i = j = k = 0
            while i < len(left_half) and j < len(right_half):
                if left_half[i] < right_half[j]:
                    arr[k] = left_half[i]
                    i += 1
                else:
                    arr[k] = right_half[j]
                    j += 1
                k += 1
    
            # 左側に残った要素を配列にコピーする
            while i < len(left_half):
                arr[k] = left_half[i]
                i += 1
                k += 1
    
            # 右側に残った要素を配列にコピーする
            while j < len(right_half):
                arr[k] = right_half[j]
                j += 1
                k += 1
    
    # 使用例
    arr = [64, 34, 25, 12, 22, 11, 90]
    merge_sort(arr)
    print("ソート済み配列:")
    for i in range(len(arr)):
        print("%d" %arr[i]),

    4.選択ソート

     データ内の最小値(最大値)の値を見つけて、左から順番に並び替える
       計算回数は、o(n^2)

     サンプルコード

    def selection_sort(arr):
        n = len(arr)
        # 配列の先頭から末尾まで、最小値を選択して配置する
        for i in range(n):
            min_index = i
            for j in range(i+1, n):
                if arr[j] < arr[min_index]:
                    min_index = j
            arr[i], arr[min_index] = arr[min_index], arr[i]
    
    # 使用例
    arr = [64, 34, 25, 12, 22, 11, 90]
    selection_sort(arr)
    print("ソート済み配列:")
    for i in range(len(arr)):
        print("%d" %arr[i]),

    5.挿入ソート

     左から順番に要素を比較しながら入れ替えていく方法
       計算回数は、最大でn(n-1)/2

     サンプルコード

    def insertion_sort(arr):
        n = len(arr)
        # 配列の先頭から末尾まで、要素を挿入して配置する
        for i in range(1, n):
            key = arr[i]
            j = i - 1
            while j >= 0 and key < arr[j]:
                arr[j+1] = arr[j]
                j -= 1
            arr[j+1] = key
    
    # 使用例
    arr = [64, 34, 25, 12, 22, 11, 90]
    insertion_sort(arr)
    print("ソート済み配列:")
    for i in range(len(arr)):
        print("%d" %arr[i]),

    6.ヒープソート

     二分木(親1に対して子2のツリー構造)の一種を構築して並べ替えをおこなう
       計算回数は、O(n log n)

     サンプルコード

    def heapify(arr, n, i):
        largest = i  # 親ノード
        l = 2*i + 1  # 左の子ノード
        r = 2*i + 2  # 右の子ノード
    
        # 左の子ノードが親ノードより大きい場合
        if l < n and arr[largest] < arr[l]:
            largest = l
    
        # 右の子ノードが親ノードより大きい場合
        if r < n and arr[largest] < arr[r]:
            largest = r
    
        # 親ノードが最大値でない場合、親ノードと最大値を交換する
        if largest != i:
            arr[i], arr[largest] = arr[largest], arr[i]
    
            # 子ノードのヒープも修正する
            heapify(arr, n, largest)
    
    def heap_sort(arr):
        n = len(arr)
    
        # 最初に、配列をヒープ構造にする
        for i in range(n // 2 - 1, -1, -1):
            heapify(arr, n, i)
    
        # ヒープから一つずつ最大値を取り出して、配列の末尾に配置する
        for i in range(n-1, 0, -1):
            arr[i], arr[0] = arr[0], arr[i]  # 最大値を末尾に配置
            heapify(arr, i, 0)  # 未ソート部分のヒープを再構築する
    
    # 使用例
    arr = [64, 34, 25, 12, 22, 11, 90]
    heap_sort(arr)
    print("ソート済み配列:")
    for i in range(len(arr)):
        print("%d" %arr[i]),
     

  • 画像自動生成AI

     どんな画像が欲しいかを指示すると、
       AIがそれに沿った画像を自動生成する仕組み

    1.画像生成サービス

     MidJourney
       2022年7月にオープン、ベータ版の使用開始
       欲しい画像を英文テキストで入力する
         AIがそれに沿った画像を自動生成する
       DiscordのBotコマンドを使用し画像を作成する
         DiscordのBot・・・オンライン環境で決められた手順で処理される
       一定数までの画像生成は無料、超えると有料サービスになる

     AIピカソ(iOS版、Android版)
       2022年8月31日に公開
       Stable Diffusionを使用する
       文章を入力すると、AIが画像生成してくれるスマホアプリ
         
     お絵描ばりぐっとくん
       2022年8月28日に公開
       Stable Diffusionを使用する
       文章をLINE公式アカウントに送信すると、
         AIが画像生成してくれるLINEアプリ

       1日に絵を描いてもらえる回数は1アカウント10回まで
         500円で無制限になる
         Stable Diffusionを使用する
         文章を入力すると、AIが画像生成してくれるサービス

     memeplex
       2022年8月27日に公開
       Stable Diffusionを使用する、今後他のエンジンも追加予定
       日本語で指示するだけで作画させることができる無料サービス
         日本語は英語に自動翻訳されるので
         漠然としたものを作るのが得意なエンジンなので
         日本語の指示を繰り返し工夫・改善しながら生成する

     novelAI
       2021年6月15日公開
         最初は小説(文章)を生成するサービス
         文章を入力すると次の文章を予測して文章が出てくる
       2022年10月3日
         Stable Diffusionを使用した画像生成機能が付加される
         日本語で指示するだけで作画させることができるサービス
         画像の生成は有料となる

     Stable Diffusion
       2022年8月23日に無償公開
       欲しい画像を英文テキストで入力する
         AIがそれに沿った画像を自動生成する

       ソースコードが公開されている
         生成する画像を人為的に制限しない(チエックしない)仕組み
         モデルがディープフェイクの作成に使用できてしまう

         モデルを使う上ではその詳細な理解は必要ない
           Webサイトが提供しているサービスを利用したり
           ローカルPCやGoogle Colabにモデルをインストールして
             スクリプトを実行したり
             プログラムコードを記述/実行したり、できる
           デモサイトで手軽に試すことも可能

    2.モデル

     Stable
       Stable Diffusionのモデルデータ
       アニメ絵以外は最強
       memeplex、AIピカソ、ばりぐっとくんで使われている

     Waifu
       2次元イラスト490万枚以上のモデルデータ
       和風アニメ(美少女)が強い
       イラストに特化する
         memeplexで使われている

     trinart
       約1920万枚+αで訓練を行ったキャラクターに特化したモデルデータ
         他のモデルとは全く使えるプロンプトの内容が異なる
       和風アニメに強い
       アニメ・マンガ特有のあらゆる表現が通る
         memeplexで使われている


    Stable

    Waifu

    trinart

    3.補足

     更新日時点での情報であり
       現在、急速に拡大している領域です
       都度、最新情報を確認してください


  • 画像自動生成AIと著作権

     著作権法的に問題になる3つの点を説明する

    0.全体像

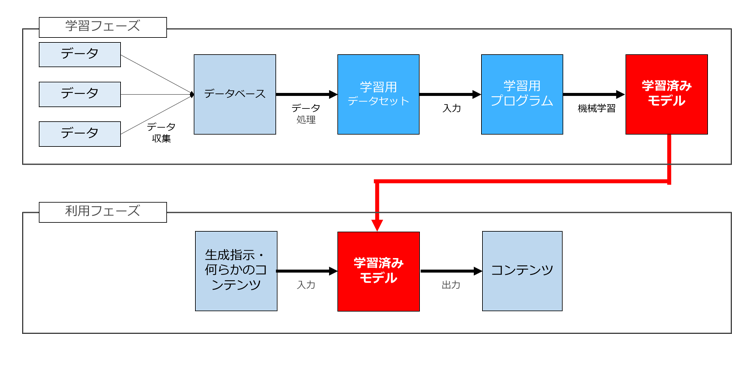
     AIソフトウェアの開発(学習・訓練)や、AIソフトウェアの利用の全体像
       画像自動生成の工程は学習フェーズと利用フェーズの2つで構成される

    画像自動生成AIの全体像

    1.他人の著作物を収集し利用すること

    学習フェーズ
     AIソフトウェアを開発・提供するサービサーに関連する部分
       AIIソフトウェアを生成するために
       他人の画像や文章などの著作物を勝手に収集して利用することができるか

     他人の著作物を勝手に収集して機械学習技術を用いて画像生成には
       元となるデータ(著作物)をネット上で収集します

     日本著作権法30条の4第2号の権利制限規定
       収集されたデータの著作権は通常データの生成者が保有しているため
       学習フェーズでAIソフトが使用するには著作権者の許諾が必要

       平成30年改正著作権法によって導入された著作権法30条の4第2号
         生成に必要な著作物の利用行為(データの複製や翻案)は、
         原則として著作権者の承諾を行わなくても可能である
         ただし、著作権者の利益を不当に害する場合は不可とした

         平成30年には「情報解析」に利用するためなら
           原則として著作物を自由に利用できる、とした上に
           いずれの方法によるかを問わず、と規定した

         そのため、著作物の使用目的に関する限定がないため、
           現在では自由にデータを使用できる状態

     日本著作権法は国内法(※日本国内に関する法律)
       作業者とサーバの両方が国内なら著作権法が適用されます
       作業者またはサーバのいずれかが外国なら著作権法は適用されません

       利用行為が日本国内であれば著作権法が適用されます
         著作権者が日本なのか外国なのか
         著作物の利用者が日本なのか外国なのか は無関係で
         あくまでも利用行為が国内の場合のみ適用されます

     次の問題は
       著作権者が使用禁止と明記し、画像生成を制限している場合は

       30条の4第2号で営利・非営利問わず著作物の利用行為が可能となるが
       著作者が自ら「AI学習に使うのは禁止にします」と表明した場合は
         原則、使用するには著作権者の承諾が必要なのですが、
         権利制限規定に該当すれば承諾がなくとも利用が可能です
           ※権利制限規定には
             著作物が自由に使える多種多様な条件を規定している

         著作者が禁止にします、と表明するだけで契約が成立するかどうか
           契約は一方的な表明だけでは成立しない
           成立するためには当事者双方の意思が合致することが必要

           契約は締結した当事者間でしか契約内容の効力は及ばない
             契約を締結していない第三者がデータを利用することは可能

         Zは利用規約に同意しておらず利用規約に拘束されないからです。 
      

    2.自動生成された画像の著作権

    利用フェーズ
     AIソフトウェアを利用して画像を自動生成するユーザに関連する部分
        自動生成された画像に著作権が発生するか

     著作権が発生するのは人間の創作物に限られている
       AIの利用により作成されたコンテンツには著作権は発生しない

       「人間が創作した」と「AIの利用により作成された」の線引き
         人間に「創作的寄与」があったかによって判断される
         AIに具体的かつ詳細な指示をしたか、によって判断される

       人間が簡単な指示しかしていなければ、
         生成された画像がいかに独創的であったとしても著作権は発生しない

       現在使われている画像自動生成AIは
         短い呪文を入力したら一発で素晴らしい画像が出て来る
         「創作的寄与」がなく、著作権が発生しない可能性が高い

         詳細かつ長い呪文(秘密の呪文)を唱えて画像を生成した場合は
           「創作的寄与」があり、著作権が発生する可能性が高い
           通常は何度も呪文を唱えて複数の画像を生成し
             その中から好みの画像をピックアップする
             明らかに「創作的寄与」が行われている

         画像自動生成AIの生成物には著作権が発生する

     呪文を法的に保護する方法
       呪文自体を著作物として保護する場合
         呪文が「読んで意味のある文章」なら著作物である
         呪文が文章とは言えないなら著作物ではない
     
         特別な意味を持つ呪文は著作物になる
           呪文が著作物に該当しても効果が無い
             著作物として管理する手間が大変になる
             利用するにしても承諾を得る手間が大変になる
             著作物として保護しても従う人はいない

       呪文が著作物に該当しても保護できない場合
         呪文を不正競争防止法上の営業秘密にし
         良い呪文が見つかったら秘匿し
           販売・提供する際には秘密保持契約を締結した上で提供する

     自動生成された画像の著作権は誰が有するか
       画像生成AIソフトウェアの制作者には著作権はありません
       画像やデータセットを生成・提供した者にも著作権はありません
       長い呪文を唱えて画像を生成した者には著作権が発生する

       「呪文を作成した人」と「呪文を使って画像生成をした人」が別人の場合
         複雑になってまとめきれず、案は幾つかある
           AIソフトを著作者とする
           AIソフトの作成者を著作者とする

    3.偶然に生成された場合の著作権侵害

    利用フェーズ
     サービス提供者とサービス利用者双方に関連する部分
       学習に用いられた画像と同一の画像が『偶然』自動生成された場合、
       著作権侵害に該当するか

       サービス提供者は画像自動生成AIというツールを提供し、
       サービス利用者は同ツールを利用して画像を自動生成する
         学習フェーズでデータとして取集したデータと
         利用フェーズで出来上がった画像が同じになった場合のこと     

         自動生成した画像を利用した利用者が著作権侵害になるのか
         仮に利用者が侵害したとなった場合、提供者も責任を負うのか

     同じ画像が生成されて著作権侵害になる要件
       作風の類似に過ぎない場合
         類似性・・・作風・スタイルレベルで類似している場合
                 類似性を満たさず、著作権侵害には該当しない
               表現レベルで類似している場合
                 類似性を満し、著作権侵害には該当する
           必ずしもはっきりしたものではないため、争いになる

       依拠性の有無の場合
         依拠性・・・他人の著作物に依拠するかどうか
                 学習用データセットに含まれていれば依拠性あり
                 既存著作物がパラメータ化されてれば依拠性なし
           結論は出ていない

     著作権侵害に該当する場合に誰が責任を負うのか
       ユーザ
         ユーザ自身が既存著作物の複製行為を行っていることになる
           私的領域内だと適法
           販売・配信した場合は著作権侵害に該当する
             ユーザに故意・過失がない場合は損害賠償請求はできない

       ツール提供者
         学習用データセットの生成・提供行為
           データセットは著作権侵害につながる危険性は相当に低い
           法的責任を問われることはない

         画像自動生成AIソフトウェアの生成・提供行為
           十分な量のデータセットを元データとして生成された画像は
           類似した画像は極めて偶然にしか生成されない
           法的責任を問われることはない
     
           既存著作物と同じ画像が非常に高い確率で生成される場合
           類似したデータのみ収集したデータセットの場合
           法的責任を問われる
     
         画像自動生成AIソフトウェア生成ツールの提供行為
           データの学習によってツールの危険性は異なること
           ツールの提供行為を行っただけ
           法的責任を問われることはない

     著作権以外の権利の侵害
       パブリシティ権侵害
         有名人の肖像が自動生成された場合

       名誉権侵害
         実在の人物の顔に裸体を合成した画像が出力された場合

  • 独自ドメインの利用

     独自ドメインを導入(利用)すべき理由を説明します

    1.独自ドメインとサブドメイン

     独自ドメインとは、独自に名前を登録しているインターネット上の住所
       世界で唯一無二の住所として利用できます
         Webサイト(URL)とメール(アドレス)に使用されます
       名前を登録するには登録料、維持するには維持費が掛かります

     サブドメインとは、独自ドメインから用途別に割振られるインターネット上の住所
       多くの場合、独自ドメインの管理者から無料で貸し与えられます
       無料大型ブログ、無料ホームページ等々に多数存在します

    2.独自ドメインとサブドメインの比較

    比較項目独自ドメインサブドメイン
    費用有料無料
    利用期限契約(維持費の支払)による管理者の方針により左右される
    利用制限自由度が高い制約事項が存在する
    信頼性対外的な信頼性の向上記憶に残らず印象が薄くなる
    SEO対策工夫・改善が行える工夫・改善の余地が少ない

    3.比較項目の説明

    ・費用
      独自ドメインは新規登録および契約更新の際に費用が掛かります
        登録先(ドメイン管理者)業者によって費用は異なります
        登録種別(用途や意味)により金額に幅が有ります
          数百円~数千円と幅が有ります

      サブドメインは無料で利用できます

    ・利用期限
      独自ドメインは毎年の更新費(維持費)を支払えば永続的に利用できます

      サブドメインは独自ドメイン所有者の運営方針に左右されます
        社会情勢によるサービス打切りの不安が付きまといます  

    ・利用制限
      独自ドメインは契約範囲内での利用には制限がありません

      サブドメインでは割振られた範囲内での利用になります
        複数の登録者での利用ですから割当てられるリソースには制限が有ります
        容量、ファイル数、1回当たりの扱い量等々に制約があります

    ・信頼性
      独自ドメインは所有者の情報を公開することによって信頼性を高めます
        氏名、住所、電話番号、メールアドレスを公開する必要があります
        多くの登録先(ドメイン管理者)業者には無料の代行サービスがあります
          所有者の情報は業者が管理し、代わりに業者の情報が公開されます

      サブドメインは親となる独自ドメインの子ども扱いになりますので
        親の独自ドメインの信頼性に引っ張られた扱いになります

    ・SEO対策
      独自ドメインはサイトのアクセス数をアップさせたい方にお勧めです
        所有者自身の努力でアクセスアップに繋げることができます

      サブドメインではHTMLヘッダーの修正は許可されていない(ことが多い)
        サイトの内容等でアクセス数をアップさせてください


  • 開発環境

    各開発環境の比較ではありません、使ったモノを記載しています

    1.プログラム開発環境

    名称URLHP特徴
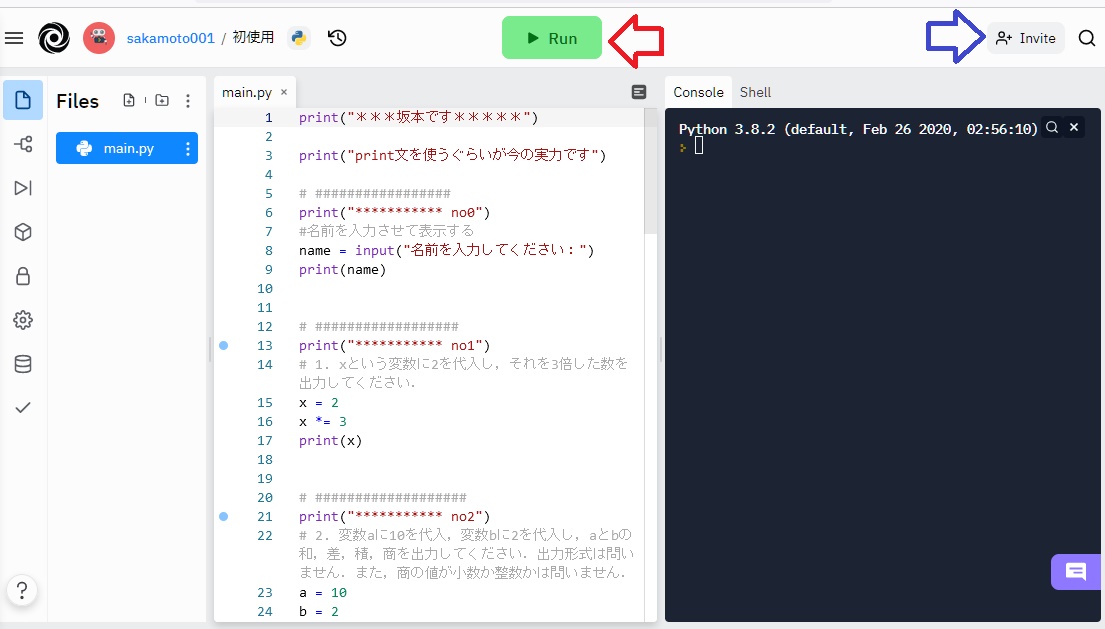
    repl.ithttps://replit.com/統合型開発環境

     「repl」とは「Read Eval Print Loop」の省略形
       直訳だと「読んで、評価し、出力を繰り返す」となります

     様々なプログラミング言語を Repl (読み込み)し
     Webブラウザ上で編集・実行が可能なWebサービスです

    使い方
      ・アカウント登録(無料のSignUp)します
      ・ログインすると開発環境(編集画面)が表示されます

      ・左端の画面でファイル操作を行う
      ・中央の画面でコーディングする
        赤矢印部分(run)のクリックでインタラクティブな実行
        青矢印部分(invite)のクリックで招待し画面を共有する
          ・ユーザー名で招待する、ことができます
          ・リンク先のURLを生成し公開する、ことができます
      ・右端の画面に実行結果が表示される

     使い方の特徴
      ・「招待」することによって、複数人と画面共有ができる
         上級者によるコーディングの指導等に使用できる
      ・50種類以上の言語が環境準備なしで即時にテスト可能です

  • 機械学習

    機械学習の全体の流れを解説する

    1.計画の立案

     機械学習の目的を決め、目的に沿った手順と予測精度等をまとめて事前に資料化する。

    2.データの収集

     以下の点を考慮し必要なデータを可能な方法で収集する。
       データの概要
         データに含まれる項目、内容、期間等を把握する
       データの形式
         数値データが基本、なるべくテキスト化され方が扱い易い
       データの作成過程
         作成過程の違いによって前処理の負荷が変わってくる
       入手先
         入手に関しては正式な手続きで行う
       入手コスト
         有償データも考慮してみる
       個人情報や機密情報
         可能な限り収集しない

    3.データの前処理

     収集したデータを機械学習できるように整える。データに合わせて試行錯誤しながらプログラムを組み立てる。 既に数多くのデータ操作用にプログラムが各データ構成に対して用意されているので、取捨選択し使用する。
     前処理の結果として処理済みデータ(目的変数、説明変数)が残る。
       データの読み込み
         「Pandas」ライブラリの「DataFrame」をよく使用する
         データ操作の「Pandas」については後段の補足参照
       データの確認
         データの分布、偏りをグラフ等を使って確認する
       欠損値の確認
         データの不備を補ったりデータの誤りを修復する
       データ型の変換
         文字列等を数値データに変換する
       説明変数の作成
         必要に応じて、モデル構築に有効な説明変数に加工する
         不要な説明変数は削除する
       データの正規化
         必要に応じて、データを一定の範囲内に収める

    4.モデルの構築、学習、評価

     モデル構築にはプログラムの作成が不可欠。既に数多くのプログラムが各モデルに対応して用意されているので、取捨選択し使用する。
       データの分割
         既存のデータを学習用に8割程度、評価用に2割程度に分割
         さらに学習用データを
           学習用に8割程度、学習中の検証用に2割程度に分割
       モデルの選択
         多くのモデルの中からデータに適したモデルを選び出す
         機械学習用ライブラリの「scikit-learn」は後段の補足参照
       モデルの学習、評価、調整
         選択したモデルを使って、学習用データで学習する
         学習済みモデルの性能を検証用データを使って評価する
         最後に評価用データを使ってモデルの性能を評価する

    5.導入

     準備作業の一環として前工程と並行して進める。
       導入形態の検討
         テスト環境から本番環境への移行
         ユーザインターフェース
         他システムとの調整
       本番環境の調査
         必要なソフトの準備(インストール等)
         システム統合された環境の整備
       既存システムの修正
         導入効果を測定するための環境整備
         運用・保守の検討および実行
                 

    6.運用、モデルの改善

     モデルの予測精度は徐々に悪化するのが一般的。
       定期的に予測精度のモニタリングを行う
       新しいデータを収集してモデルの再学習を行う
       学習結果の反映を行う

    <補足>

     データの前処理に利用するライブラリ


    pandas
    データ解析を支援するライブラリ
     数表および時系列データを操作するためのデータ構造と演算を提供する

     扱うデータ型式はCSV、テキストファイル、Excel、SQLデータベース 等々

     モデルの選択時に利用するライブラリ


    scikit-learn
    オープンソース機械学習ライブラリ
     様々な分類、回帰、クラスタリング等のアルゴリズムを備えたライブラリ

     データを分析したり加工したりできる

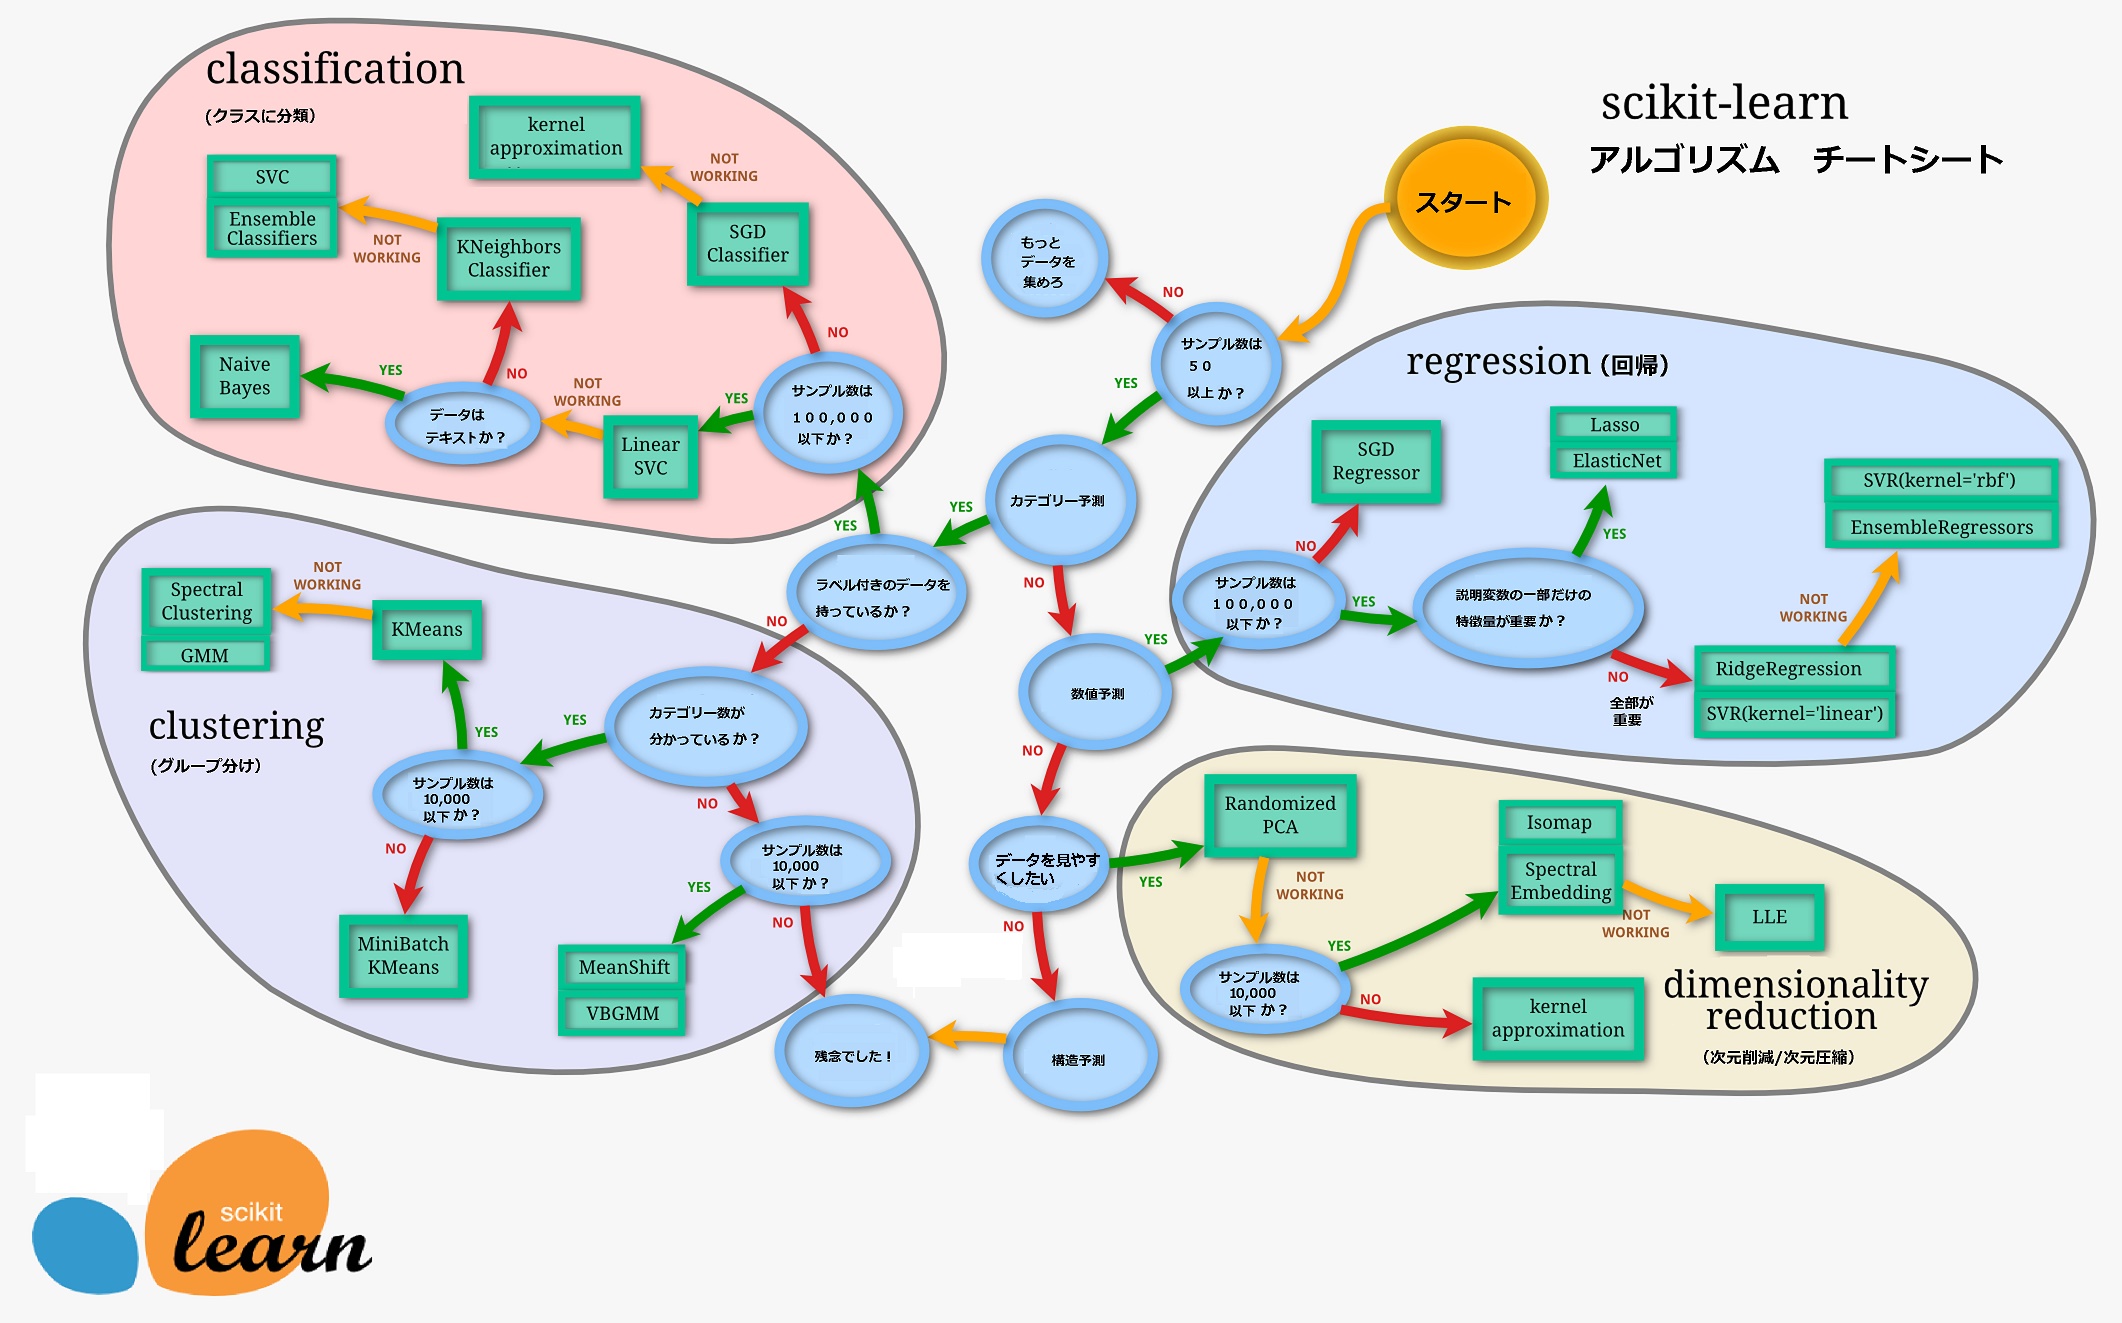
    チートシート
    「チートシート(虎の巻)」の例
     モデル選択の際、「虎の巻」として参考にする
     数種類の「虎の巻」が既に存在する
  • Webサイト作成

    前提条件(レンタルサーバー、)を置いて記述します

    1.レンタルサーバー

     Webサイトのデータを保管するサーバーのレンタル費用が必要
       数多くのレンタルサービスがあるので、その中から選ぶ

       広告の掲載が条件で無料のレンタル会社も有ります

     一般的にはCPUと大容量メモリを調べる
       提供会社によって付加されるサービスは様々
       途中解約等も考慮しながら慎重に選ぶ

    2.独自ドメイン

     サイトURLを表す独自ドメインを取得し、維持費を払う
       初回には登録料、毎年には継続料が必要
         ※サブドメインを無料で用意している会社もあります

    3.SSL証明書

     SSL証明書を発行する際に費用が必要
       サーバー管理会社によって種々のサービスがあります
         ※無料の会社も有ります

     SSL証明書を使用するじょとによって通信データの暗号化を証明する
       ユーザーは安心してWebサイトを閲覧できる

  • XML文書の展開

    構造化されたXML文書を読みやすい文章(平文)に展開する

    1.XML文書の特徴

     XML(eXtensible Markup Language)は言語の仕様のことで、「拡張可能なマークアップ言語」と訳されており、文書のもつ「見出し」「本文」・・・などの論理構造を「タグ(<>で囲む)」と呼ばれるもので記述します。要するに文書の内容一つ一つに名前(タグ)を付与し、「タグ」を検索項目として文書の内容を読み取るといった手法を使って「書き手」と「読み手」の間で間違いなく情報を交換できるといった利点があります。

    2.XML文書の例

    <rdf:RDF xmlns="http://purl.org/rss/1.0/" xmlns:dc="http://purl.org/dc/elements/1.1/" xmlns:sy="http://purl.org/rss/1.0/modules/syndication/" xmlns:admin="http://webns.net/mvcb/" xmlns:rdf="http://www.w3.org/1999/02/22-rdf-syntax-ns#" xml:lang="ja">
    
    <channel rdf:about="">
    <title>●●●日本語でタイトルを記述●●●</title>
    <link/>
    
    <description>●●●日本語で文書の内容を記述●●●</description>
    <dc:date>2021-06-26 00:00:00+09:00</dc:date>
    <dc:creator/>
    <dc:subject/>
    <dc:rights>Copyright ●●●著作権の所有者を記述●●●</dc:rights>
    <sy:updatePeriod>weekly</sy:updatePeriod>
    <sy:updateFrequency>1</sy:updateFrequency>
    </channel>
    
    <item rdf:about="●●●文書のURL●●●">
    <title>新型コロナウイルスの感染症対策</title>
    <link>●●●項目の詳細情報を掲載するURL●●●</link>
    <description/>
    <dc:date>2021-06-09T00:00:00+09:00</dc:date>
    <dc:subject>●●●副題を記述●●●</dc:subject>
    </item>
    
    </rdf:RDF>

    (例)新着情報として提供される内容
      4行目・・・文書のタイトル
      7行目~14行目・・・文書全体の説明
      16行目~22行目・・・項目の記述、項目の数だけこの部分を繰返す
        ※20行目と21行目は19行目の内容を複数行の情報で補う

    3.XML文書を読み込む

    	$i = 0;
    	$url = "●●●新着情報が掲載されているurl●●●";
    	$rss = simplexml_load_file($url);
    
    if ($rss)
      {
    	 foreach ($rss->item as $item)
    		 {
    		  $title	= $item->title;
    		  $link 	= $item->link;
    	   $desc 	= $item->description;	
    		  $date 	= date('Y年 m月 d日', strtotime($item->children("http://purl.org/dc/elements/1.1/")->date));	
       ●●●項目に対する処理を記述●●●
         }
      }
    else
      {
     	echo "エラー発生";
      }
    

     3行目・・・XML文書(ファイル)全体を取り出す命令
     7行目~14行目・・・<item>タグが存在する間、繰返す
       ※各項目(item)をタグ名で取り出す(title、link、date等々)

     概ね新着情報等は規則正しく構成されているので、丁寧に構造を観察すれば、上記サンプルを修正するだけで読み込めます。

    4.注意点(simplexml_load_file)

     テスト段階で以下の様なメッセージが表示される場合
     
      simplexml_load_file(): httWarning:ps:// wrapper is disabled in the server configuration by allow_url_fopen=0 in /●●●エラー発生のソースライン番号●●●

     使っているサーバーが外部のXMLデータの読込を許可していないために発生するエラーです。
     先ず使用しているサーバーの「php.ini」の「allow_url_fopen」パラメーターをチエックしてください。「allow_url_fopen=0」だと読込が許可されていないので外部のXMLデータは読込めません、「allow_url_fopen=on」に変更してください。
     「php.ini」の変更ができないサーバーだと「simplexml_load_file」の命令は使用できないので別の方法(テキスト形式のファイルとして読込む方法)でお願いします。

  • アプリの開発

    技術論に陥らず、方向性を検討する

    1.アプリには2種類ある

     課題解決を図る際にプログラミングが必要となれば、「Webアプリ」と「ネイティブアプリ」とを十二分に検討する必要がある。

     Webアプリ・・・インターネット(ウェブ)などのネットワークを利用するアプリケーションソフトウェア。プログラム本体はネットワーク上のWEBサーバー内に存在し、WEBブラウザを使って操作する。よく知られる例として動画共有サービス「YouTube」やウェブメールサービス「Gmail」、インターネット電話サービス「Skype」などがあげられる。

     ネイティブアプリ・・・手元の端末(スマートフォン・PC等)にインストールして利用するアプリケーションソフトウェア。プログラム本体は手元の端末内に存在する。よく知られる例として「App store」や「Google Play」経由で配布しダウンロードされるアプリがあげられる。

    2.各アプリの特徴を理解する

     アプリ開発に先立って、2種類のアプリのどちらかを選ぶ際の参考に比較表を用意する。

    Webアプリ ネイティブアプリ
    動作環境 アプリはインターネットを介してサーバー上で動作する アプリはダウンロードしたデバイス上で動作する
    動作速度 インターネットを通してサーバー上で動くので動作が遅く感じる 直接デバイス上で動くので動作が速い
    機能 フロント部分には工夫や配慮を施せる

    バック部分では大容量のデータを複雑に取り扱うことができる
    デバイス自体が持つ機能が利用できる
     地図の位置情報
     温度・方角 等
     身体の特徴(体温)
    開発言語 フロント部分にはHTML、JavaScript、CSS等他種多様な言語を使用する

    バック部分にはPHP、Java、Ruby、Python、SQL等の多種多様な言語を開発目的に合わせて使用する

    Android版
     Kotlin

    iOS版
     Swift

    開発コスト ゼロから独自開発すると、開発コストや期間が掛か
    公開費用 サーバー運用費に含まれ、公開に対しては無料

    Android版
     初回登録約3千円

    iOS版
     毎年約1万2千円

    公開審査 不要

    Android版
     無し

    iOS版
     審査あり(数日程度)

    使用開始 ブラウザでサイトにアクセスするだけで利用できる手軽さがある

    各サイトからダウンロードする

    Android版

     Google Play経由

    iOS版
     App store経由

    継続使用 広く浅くアクセスするユーザが多く、ロイヤリティが高いとは言えない ダウンロードしてまで利用するので、ロイヤリティが高いユーザーだと言える
    課金の仕組み 課金する場合にストアを通す必要がなく、手数料を支払う必要はない 課金する場合にはストア側へ手数料を支払う必要がある

    3.大まかな基準

     以下のポイントで切り分けてみる 
      ネイティブアプリ・・・手許で手軽に使うアプリ
      Webアプリ・・・複雑なデータ処理を伴うアプリ