カテゴリー: Expansive

  • 画像自動生成AI

     どんな画像が欲しいかを指示すると、
       AIがそれに沿った画像を自動生成する仕組み

    1.画像生成サービス

     MidJourney
       2022年7月にオープン、ベータ版の使用開始
       欲しい画像を英文テキストで入力する
         AIがそれに沿った画像を自動生成する
       DiscordのBotコマンドを使用し画像を作成する
         DiscordのBot・・・オンライン環境で決められた手順で処理される
       一定数までの画像生成は無料、超えると有料サービスになる

     AIピカソ(iOS版、Android版)
       2022年8月31日に公開
       Stable Diffusionを使用する
       文章を入力すると、AIが画像生成してくれるスマホアプリ
         
     お絵描ばりぐっとくん
       2022年8月28日に公開
       Stable Diffusionを使用する
       文章をLINE公式アカウントに送信すると、
         AIが画像生成してくれるLINEアプリ

       1日に絵を描いてもらえる回数は1アカウント10回まで
         500円で無制限になる
         Stable Diffusionを使用する
         文章を入力すると、AIが画像生成してくれるサービス

     memeplex
       2022年8月27日に公開
       Stable Diffusionを使用する、今後他のエンジンも追加予定
       日本語で指示するだけで作画させることができる無料サービス
         日本語は英語に自動翻訳されるので
         漠然としたものを作るのが得意なエンジンなので
         日本語の指示を繰り返し工夫・改善しながら生成する

     novelAI
       2021年6月15日公開
         最初は小説(文章)を生成するサービス
         文章を入力すると次の文章を予測して文章が出てくる
       2022年10月3日
         Stable Diffusionを使用した画像生成機能が付加される
         日本語で指示するだけで作画させることができるサービス
         画像の生成は有料となる

     Stable Diffusion
       2022年8月23日に無償公開
       欲しい画像を英文テキストで入力する
         AIがそれに沿った画像を自動生成する

       ソースコードが公開されている
         生成する画像を人為的に制限しない(チエックしない)仕組み
         モデルがディープフェイクの作成に使用できてしまう

         モデルを使う上ではその詳細な理解は必要ない
           Webサイトが提供しているサービスを利用したり
           ローカルPCやGoogle Colabにモデルをインストールして
             スクリプトを実行したり
             プログラムコードを記述/実行したり、できる
           デモサイトで手軽に試すことも可能

    2.モデル

     Stable
       Stable Diffusionのモデルデータ
       アニメ絵以外は最強
       memeplex、AIピカソ、ばりぐっとくんで使われている

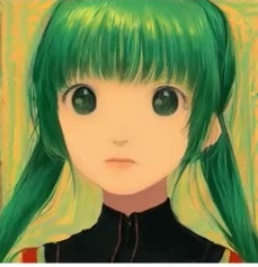
     Waifu
       2次元イラスト490万枚以上のモデルデータ
       和風アニメ(美少女)が強い
       イラストに特化する
         memeplexで使われている

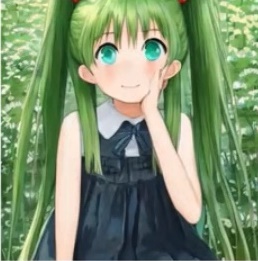
     trinart
       約1920万枚+αで訓練を行ったキャラクターに特化したモデルデータ
         他のモデルとは全く使えるプロンプトの内容が異なる
       和風アニメに強い
       アニメ・マンガ特有のあらゆる表現が通る
         memeplexで使われている

    Stable

    Waifu

    trinart

    3.補足

     更新日時点での情報であり
       現在、急速に拡大している領域です
       都度、最新情報を確認してください
     

  • 独自ドメインの利用

     独自ドメインを導入(利用)すべき理由を説明します

    1.独自ドメインとサブドメイン

     独自ドメインとは、独自に名前を登録しているインターネット上の住所
       世界で唯一無二の住所として利用できます
         Webサイト(URL)とメール(アドレス)に使用されます
       名前を登録するには登録料、維持するには維持費が掛かります

     サブドメインとは、独自ドメインから用途別に割振られるインターネット上の住所
       多くの場合、独自ドメインの管理者から無料で貸し与えられます
       無料大型ブログ、無料ホームページ等々に多数存在します

    2.独自ドメインとサブドメインの比較

    比較項目独自ドメインサブドメイン
    費用有料無料
    利用期限契約(維持費の支払)による管理者の方針により左右される
    利用制限自由度が高い制約事項が存在する
    信頼性対外的な信頼性の向上記憶に残らず印象が薄くなる
    SEO対策工夫・改善が行える工夫・改善の余地が少ない

    3.比較項目の説明

    ・費用
      独自ドメインは新規登録および契約更新の際に費用が掛かります
        登録先(ドメイン管理者)業者によって費用は異なります
        登録種別(用途や意味)により金額に幅が有ります
          数百円~数千円と幅が有ります

      サブドメインは無料で利用できます

    ・利用期限
      独自ドメインは毎年の更新費(維持費)を支払えば永続的に利用できます

      サブドメインは独自ドメイン所有者の運営方針に左右されます
        社会情勢によるサービス打切りの不安が付きまといます  

    ・利用制限
      独自ドメインは契約範囲内での利用には制限がありません

      サブドメインでは割振られた範囲内での利用になります
        複数の登録者での利用ですから割当てられるリソースには制限が有ります
        容量、ファイル数、1回当たりの扱い量等々に制約があります

    ・信頼性
      独自ドメインは所有者の情報を公開することによって信頼性を高めます
        氏名、住所、電話番号、メールアドレスを公開する必要があります
        多くの登録先(ドメイン管理者)業者には無料の代行サービスがあります
          所有者の情報は業者が管理し、代わりに業者の情報が公開されます

      サブドメインは親となる独自ドメインの子ども扱いになりますので
        親の独自ドメインの信頼性に引っ張られた扱いになります

    ・SEO対策
      独自ドメインはサイトのアクセス数をアップさせたい方にお勧めです
        所有者自身の努力でアクセスアップに繋げることができます

      サブドメインではHTMLヘッダーの修正は許可されていない(ことが多い)
        サイトの内容等でアクセス数をアップさせてください


  • 開発環境

    各開発環境の比較ではありません、使ったモノを記載しています

    1.プログラム開発環境

    名称URLHP特徴
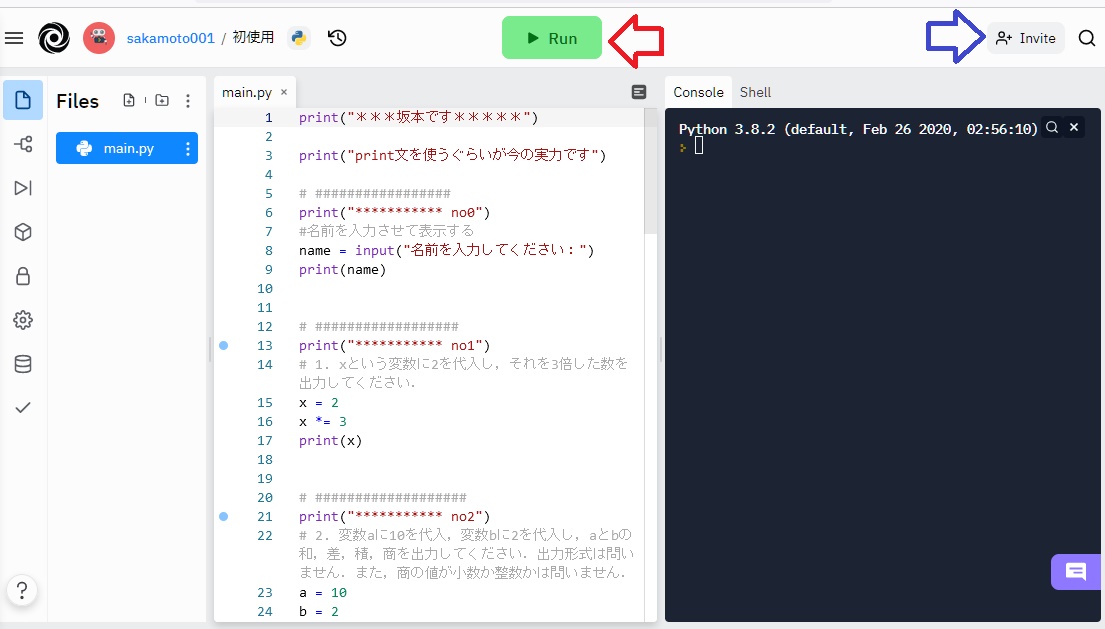
    repl.ithttps://replit.com/統合型開発環境

     「repl」とは「Read Eval Print Loop」の省略形
       直訳だと「読んで、評価し、出力を繰り返す」となります

     様々なプログラミング言語を Repl (読み込み)し
     Webブラウザ上で編集・実行が可能なWebサービスです

    使い方
      ・アカウント登録(無料のSignUp)します
      ・ログインすると開発環境(編集画面)が表示されます

      ・左端の画面でファイル操作を行う
      ・中央の画面でコーディングする
        赤矢印部分(run)のクリックでインタラクティブな実行
        青矢印部分(invite)のクリックで招待し画面を共有する
          ・ユーザー名で招待する、ことができます
          ・リンク先のURLを生成し公開する、ことができます
      ・右端の画面に実行結果が表示される

     使い方の特徴
      ・「招待」することによって、複数人と画面共有ができる
         上級者によるコーディングの指導等に使用できる
      ・50種類以上の言語が環境準備なしで即時にテスト可能です

  • 機械学習

    機械学習の全体の流れを解説する

    1.計画の立案

     機械学習の目的を決め、目的に沿った手順と予測精度等をまとめて事前に資料化する。

    2.データの収集

     以下の点を考慮し必要なデータを可能な方法で収集する。
       データの概要
         データに含まれる項目、内容、期間等を把握する
       データの形式
         数値データが基本、なるべくテキスト化され方が扱い易い
       データの作成過程
         作成過程の違いによって前処理の負荷が変わってくる
       入手先
         入手に関しては正式な手続きで行う
       入手コスト
         有償データも考慮してみる
       個人情報や機密情報
         可能な限り収集しない

    3.データの前処理

     収集したデータを機械学習できるように整える。データに合わせて試行錯誤しながらプログラムを組み立てる。 既に数多くのデータ操作用にプログラムが各データ構成に対して用意されているので、取捨選択し使用する。
     前処理の結果として処理済みデータ(目的変数、説明変数)が残る。
       データの読み込み
         「Pandas」ライブラリの「DataFrame」をよく使用する
         データ操作の「Pandas」については後段の補足参照
       データの確認
         データの分布、偏りをグラフ等を使って確認する
       欠損値の確認
         データの不備を補ったりデータの誤りを修復する
       データ型の変換
         文字列等を数値データに変換する
       説明変数の作成
         必要に応じて、モデル構築に有効な説明変数に加工する
         不要な説明変数は削除する
       データの正規化
         必要に応じて、データを一定の範囲内に収める

    4.モデルの構築、学習、評価

     モデル構築にはプログラムの作成が不可欠。既に数多くのプログラムが各モデルに対応して用意されているので、取捨選択し使用する。
       データの分割
         既存のデータを学習用に8割程度、評価用に2割程度に分割
         さらに学習用データを
           学習用に8割程度、学習中の検証用に2割程度に分割
       モデルの選択
         多くのモデルの中からデータに適したモデルを選び出す
         機械学習用ライブラリの「scikit-learn」は後段の補足参照
       モデルの学習、評価、調整
         選択したモデルを使って、学習用データで学習する
         学習済みモデルの性能を検証用データを使って評価する
         最後に評価用データを使ってモデルの性能を評価する

    5.導入

     準備作業の一環として前工程と並行して進める。
       導入形態の検討
         テスト環境から本番環境への移行
         ユーザインターフェース
         他システムとの調整
       本番環境の調査
         必要なソフトの準備(インストール等)
         システム統合された環境の整備
       既存システムの修正
         導入効果を測定するための環境整備
         運用・保守の検討および実行
                 

    6.運用、モデルの改善

     モデルの予測精度は徐々に悪化するのが一般的。
       定期的に予測精度のモニタリングを行う
       新しいデータを収集してモデルの再学習を行う
       学習結果の反映を行う

    <補足>

     データの前処理に利用するライブラリ


    pandas
    データ解析を支援するライブラリ
     数表および時系列データを操作するためのデータ構造と演算を提供する

     扱うデータ型式はCSV、テキストファイル、Excel、SQLデータベース 等々

     モデルの選択時に利用するライブラリ


    scikit-learn
    オープンソース機械学習ライブラリ
     様々な分類、回帰、クラスタリング等のアルゴリズムを備えたライブラリ

     データを分析したり加工したりできる

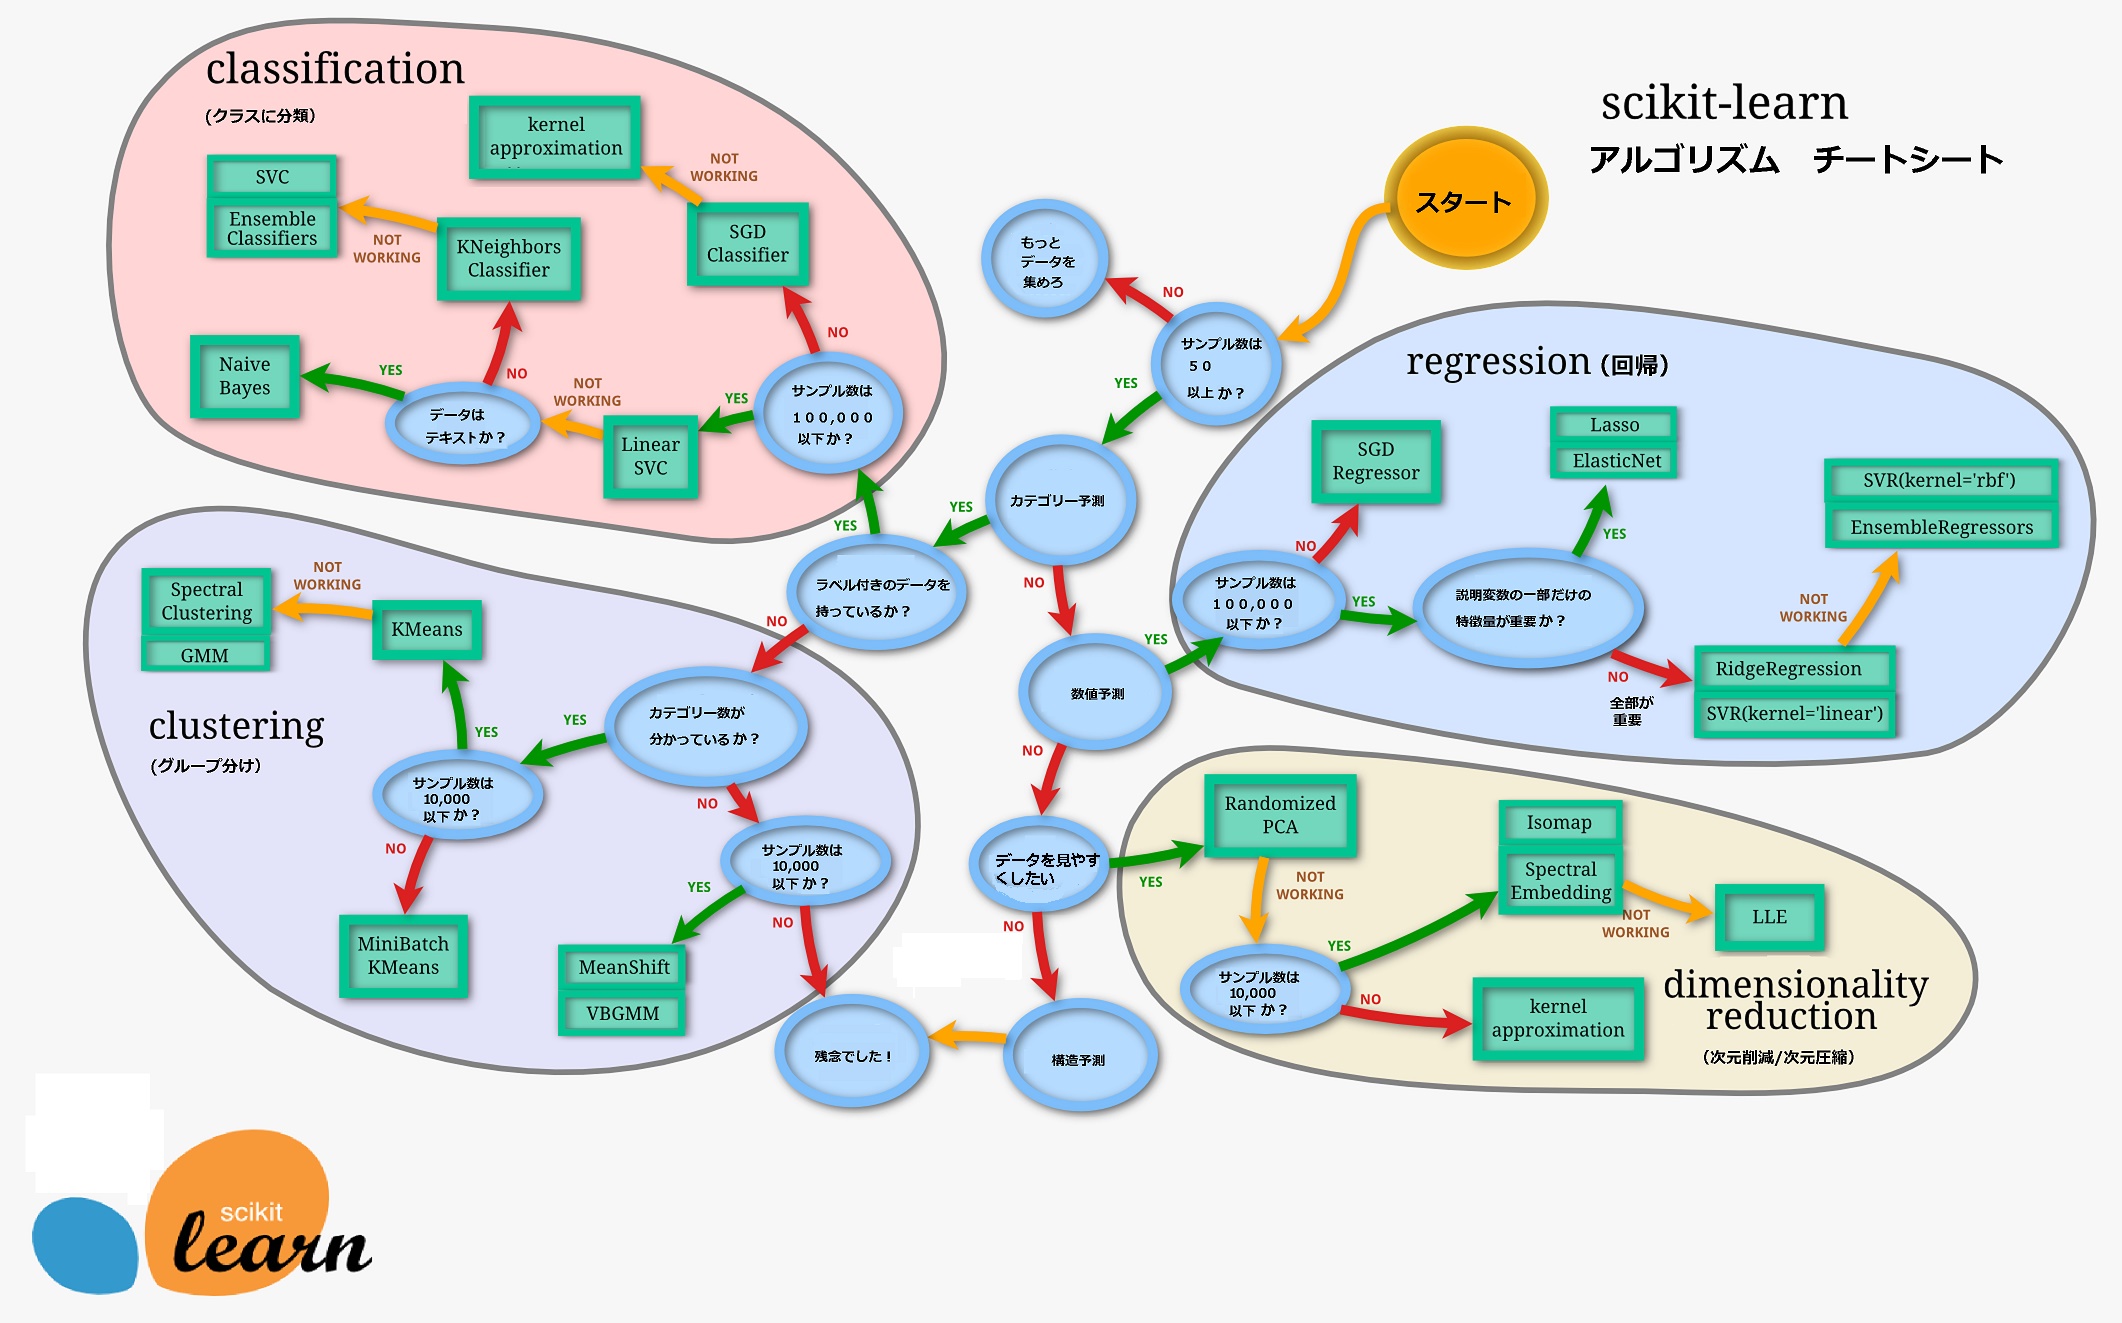
    チートシート
    「チートシート(虎の巻)」の例
     モデル選択の際、「虎の巻」として参考にする
     数種類の「虎の巻」が既に存在する
  • Webサイト作成

    前提条件(レンタルサーバー、)を置いて記述します

    1.レンタルサーバー

     Webサイトのデータを保管するサーバーのレンタル費用が必要
       数多くのレンタルサービスがあるので、その中から選ぶ

       広告の掲載が条件で無料のレンタル会社も有ります

     一般的にはCPUと大容量メモリを調べる
       提供会社によって付加されるサービスは様々
       途中解約等も考慮しながら慎重に選ぶ

    2.独自ドメイン

     サイトURLを表す独自ドメインを取得し、維持費を払う
       初回には登録料、毎年には継続料が必要
         ※サブドメインを無料で用意している会社もあります

    3.SSL証明書

     SSL証明書を発行する際に費用が必要
       サーバー管理会社によって種々のサービスがあります
         ※無料の会社も有ります

     SSL証明書を使用するじょとによって通信データの暗号化を証明する
       ユーザーは安心してWebサイトを閲覧できる

  • アプリの開発

    技術論に陥らず、方向性を検討する

    1.アプリには2種類ある

     課題解決を図る際にプログラミングが必要となれば、「Webアプリ」と「ネイティブアプリ」とを十二分に検討する必要がある。

     Webアプリ・・・インターネット(ウェブ)などのネットワークを利用するアプリケーションソフトウェア。プログラム本体はネットワーク上のWEBサーバー内に存在し、WEBブラウザを使って操作する。よく知られる例として動画共有サービス「YouTube」やウェブメールサービス「Gmail」、インターネット電話サービス「Skype」などがあげられる。

     ネイティブアプリ・・・手元の端末(スマートフォン・PC等)にインストールして利用するアプリケーションソフトウェア。プログラム本体は手元の端末内に存在する。よく知られる例として「App store」や「Google Play」経由で配布しダウンロードされるアプリがあげられる。

    2.各アプリの特徴を理解する

     アプリ開発に先立って、2種類のアプリのどちらかを選ぶ際の参考に比較表を用意する。

    Webアプリ ネイティブアプリ
    動作環境 アプリはインターネットを介してサーバー上で動作する アプリはダウンロードしたデバイス上で動作する
    動作速度 インターネットを通してサーバー上で動くので動作が遅く感じる 直接デバイス上で動くので動作が速い
    機能 フロント部分には工夫や配慮を施せる

    バック部分では大容量のデータを複雑に取り扱うことができる
    デバイス自体が持つ機能が利用できる
     地図の位置情報
     温度・方角 等
     身体の特徴(体温)
    開発言語 フロント部分にはHTML、JavaScript、CSS等他種多様な言語を使用する

    バック部分にはPHP、Java、Ruby、Python、SQL等の多種多様な言語を開発目的に合わせて使用する

    Android版
     Kotlin

    iOS版
     Swift

    開発コスト ゼロから独自開発すると、開発コストや期間が掛か
    公開費用 サーバー運用費に含まれ、公開に対しては無料

    Android版
     初回登録約3千円

    iOS版
     毎年約1万2千円

    公開審査 不要

    Android版
     無し

    iOS版
     審査あり(数日程度)

    使用開始 ブラウザでサイトにアクセスするだけで利用できる手軽さがある

    各サイトからダウンロードする

    Android版

     Google Play経由

    iOS版
     App store経由

    継続使用 広く浅くアクセスするユーザが多く、ロイヤリティが高いとは言えない ダウンロードしてまで利用するので、ロイヤリティが高いユーザーだと言える
    課金の仕組み 課金する場合にストアを通す必要がなく、手数料を支払う必要はない 課金する場合にはストア側へ手数料を支払う必要がある

    3.大まかな基準

     以下のポイントで切り分けてみる 
      ネイティブアプリ・・・手許で手軽に使うアプリ
      Webアプリ・・・複雑なデータ処理を伴うアプリ

  • コーディング規約

    「pep8(Python Enhancement Proposal)」から具体例を引用する。
      具体例を参考にし、開発環境に即して修正願います。

    1.インデントのスペース数を揃える

     「スペースは4つ」で揃えるとあるが「2つ」で問題なし。

    if num % 2 == 0:
      msg = "偶数"

    2.1行の長さは79文字まで

     「79文字以内」に制限するとあるが、読みやすさの観点からも制限を設ける方がよい。行の途中での改行は「\(半角バックスラツシュ)」を使用する。

    print(100 + 200 + 300 +\
          400 + 500)

    3.文字列の引用符を揃える

     Python では、シングルコーテーション「’」で囲まれた文字列と、ダブルコーテーション「”」で囲まれた文字列は同じで扱い。どちらかに揃える。
     文字列の中に引用符を含む場合は、逆の引用符を使う。

    str = "括弧の中についてはコーテーション'で囲む"

    4.式や文中の空白文字

     開始括弧 ( の直後や終了括弧 ) の直前には空白文字を入れない。
     カンマ 、 やセミコロン : の直前には空白文字を入れない
     カンマ 、 やセミコロン : の直後には空白文字を入れる

    print("空白文字を入れない")
    print("直前には入れない", "直後には入れる")

    5.演算子の前後に空白文字を入れる

     見易さの観点で空白文字を演算子の前後に入れる。

    weight = height * height * 22

    6.無駄なスペースは入れない

     最初は項目が揃って見易いが、その後の変更で項目の長さが変わったりすると、結果的に最初に入れたスペースは見にくくなる。

    #
    # 悪い例
    height = 1.8
    bmi    = 22
    weight = height * height * 22
    #
    # 良い例
    height = 1.8
    bmi = 22
    weight = height * height * 22

    7.スライスのコロンの前後に空白文字は入れない

     見易さを優先させる。

    list1[0:2]
    list2[::2]
    list3[4::-1]

    8.import文は行を分ける

     取込む内容を明確にする。

    #
    # 悪い例
    import item1, item2
    #
    # 良い例
    import item1
    import item2

    9.命名規則

     関数や変数
      全て小文字を使用する。単語と単語はアンダースコア(_)で区切る。
     定数
      全て大文字を使用する。単語と単語はアンダースコア(_)で区切る。
     クラス
      先頭一文字を大文字にする。
     その他
      適宜「pep8」を参照して決める。